英伟达RTX PRO 4500 Edge... Features
据StorageReview独家评测报道,英伟达RTX PRO 4500 Blackwell服务器版在HPE ProLiant DL145 Gen11边缘服务器中表现出超越前代L4 GPU的显著性能。该评测于2026年9月24日发布,围绕两款显卡在同一服务器平台上的vLLM推理服务展开对比测试,涵盖输出吞吐量、首令牌延迟及功耗三大核心指标。结果显示,在实用并发场景下,RTX PRO 4500的综合输出能力达到L4的2.7倍,同时可将首令牌延迟控制在1秒以内,而L4在高负载下已出现数秒排队等待。该显卡的设计旨在替代L4,服务于机房条件有限但需要本地AI推理的边缘站点。
感情危机设计定位:替代L4的边缘推理新选择
英伟达于2026年GTC大会上发布了RTX PRO 4500 Blackwell服务器版,将其定位为RTX PRO服务器家族入门级产品和L4的继任者。据StorageReview报道,该卡与同名的RTX PRO 4500工作站版共享同一颗芯片和10,496个CUDA核心,但服务器版移除了显示输出和散热风扇,将板卡功耗锁定在165W,并增添了数据中心级特性:支持最多两个16GB实例的多实例GPU(MIG)、机密计算、三个NVENC和NVDEC编码器,以及vGPU支持。英伟达标称其内存带宽为800GB/s,FP4张量峰值可达1.6 PFLOPS(含稀疏性)。StorageReview援引英伟达官方说法称,该卡是“面向企业AI的能效型Blackwell GPU”,主攻“主流数据中心与边缘服务器”。
感情生活核心规格对比:架构与内存的跨越式升级
与72W、24GB GDDR6、内存带宽仅300GB/s的L4相比,RTX PRO 4500带来了架构级的全面提升。以下是两卡的核心参数对比:
感情纠纷
| 规格 | RTX PRO 4500 Blackwell服务器版 | NVIDIA L4 |
|---|
| --- | --- | --- |
|---|
| 架构 | Blackwell | Ada Lovelace |
|---|
| CUDA核心数 | 10,496 | 7,424 |
|---|
| 显存 | 32GB GDDR7(带ECC) | 24GB GDDR6 |
|---|
| 内存带宽 | 800GB/s | 300GB/s |
|---|
| FP32性能 | 51 TFLOPS | 30.3 TFLOPS |
|---|
| FP8张量性能 | 811 TFLOPS | 485 TFLOPS |
|---|
| FP4张量性能 | 1.6 PFLOPS | 不支持 |
|---|
| 板卡功耗 | 165W | 72W |
|---|
| 外形规格 | 单插槽、全高、全长、被动散热 | 单插槽、半高、半长、被动散热 |
|---|
| 供电接口 | 1个PCIe CEM5 16-pin | 插槽供电 |
|---|
| 接口标准 | PCIe 5.0 x16 | PCIe 4.0 x16 |
|---|
| MIG支持 | 最多2个16GB实例 | 不支持 |
|---|
| NVENC/NVDEC | 3/3 | 2/4 |
|---|
存储评测实验室指出,RTX PRO 4500的显存容量较L4提升了33%,内存带宽更是达到2.7倍,同时FP8张量峰值为1.7倍,而功耗仅2.3倍。AP通讯社的分析师确认,在边缘服务器功耗受限的场景下,这种“每瓦特效率提升1.3至1.4倍”的表现对运营成本具有实质性改善。
实测性能:输出吞吐量与延迟的全面碾压
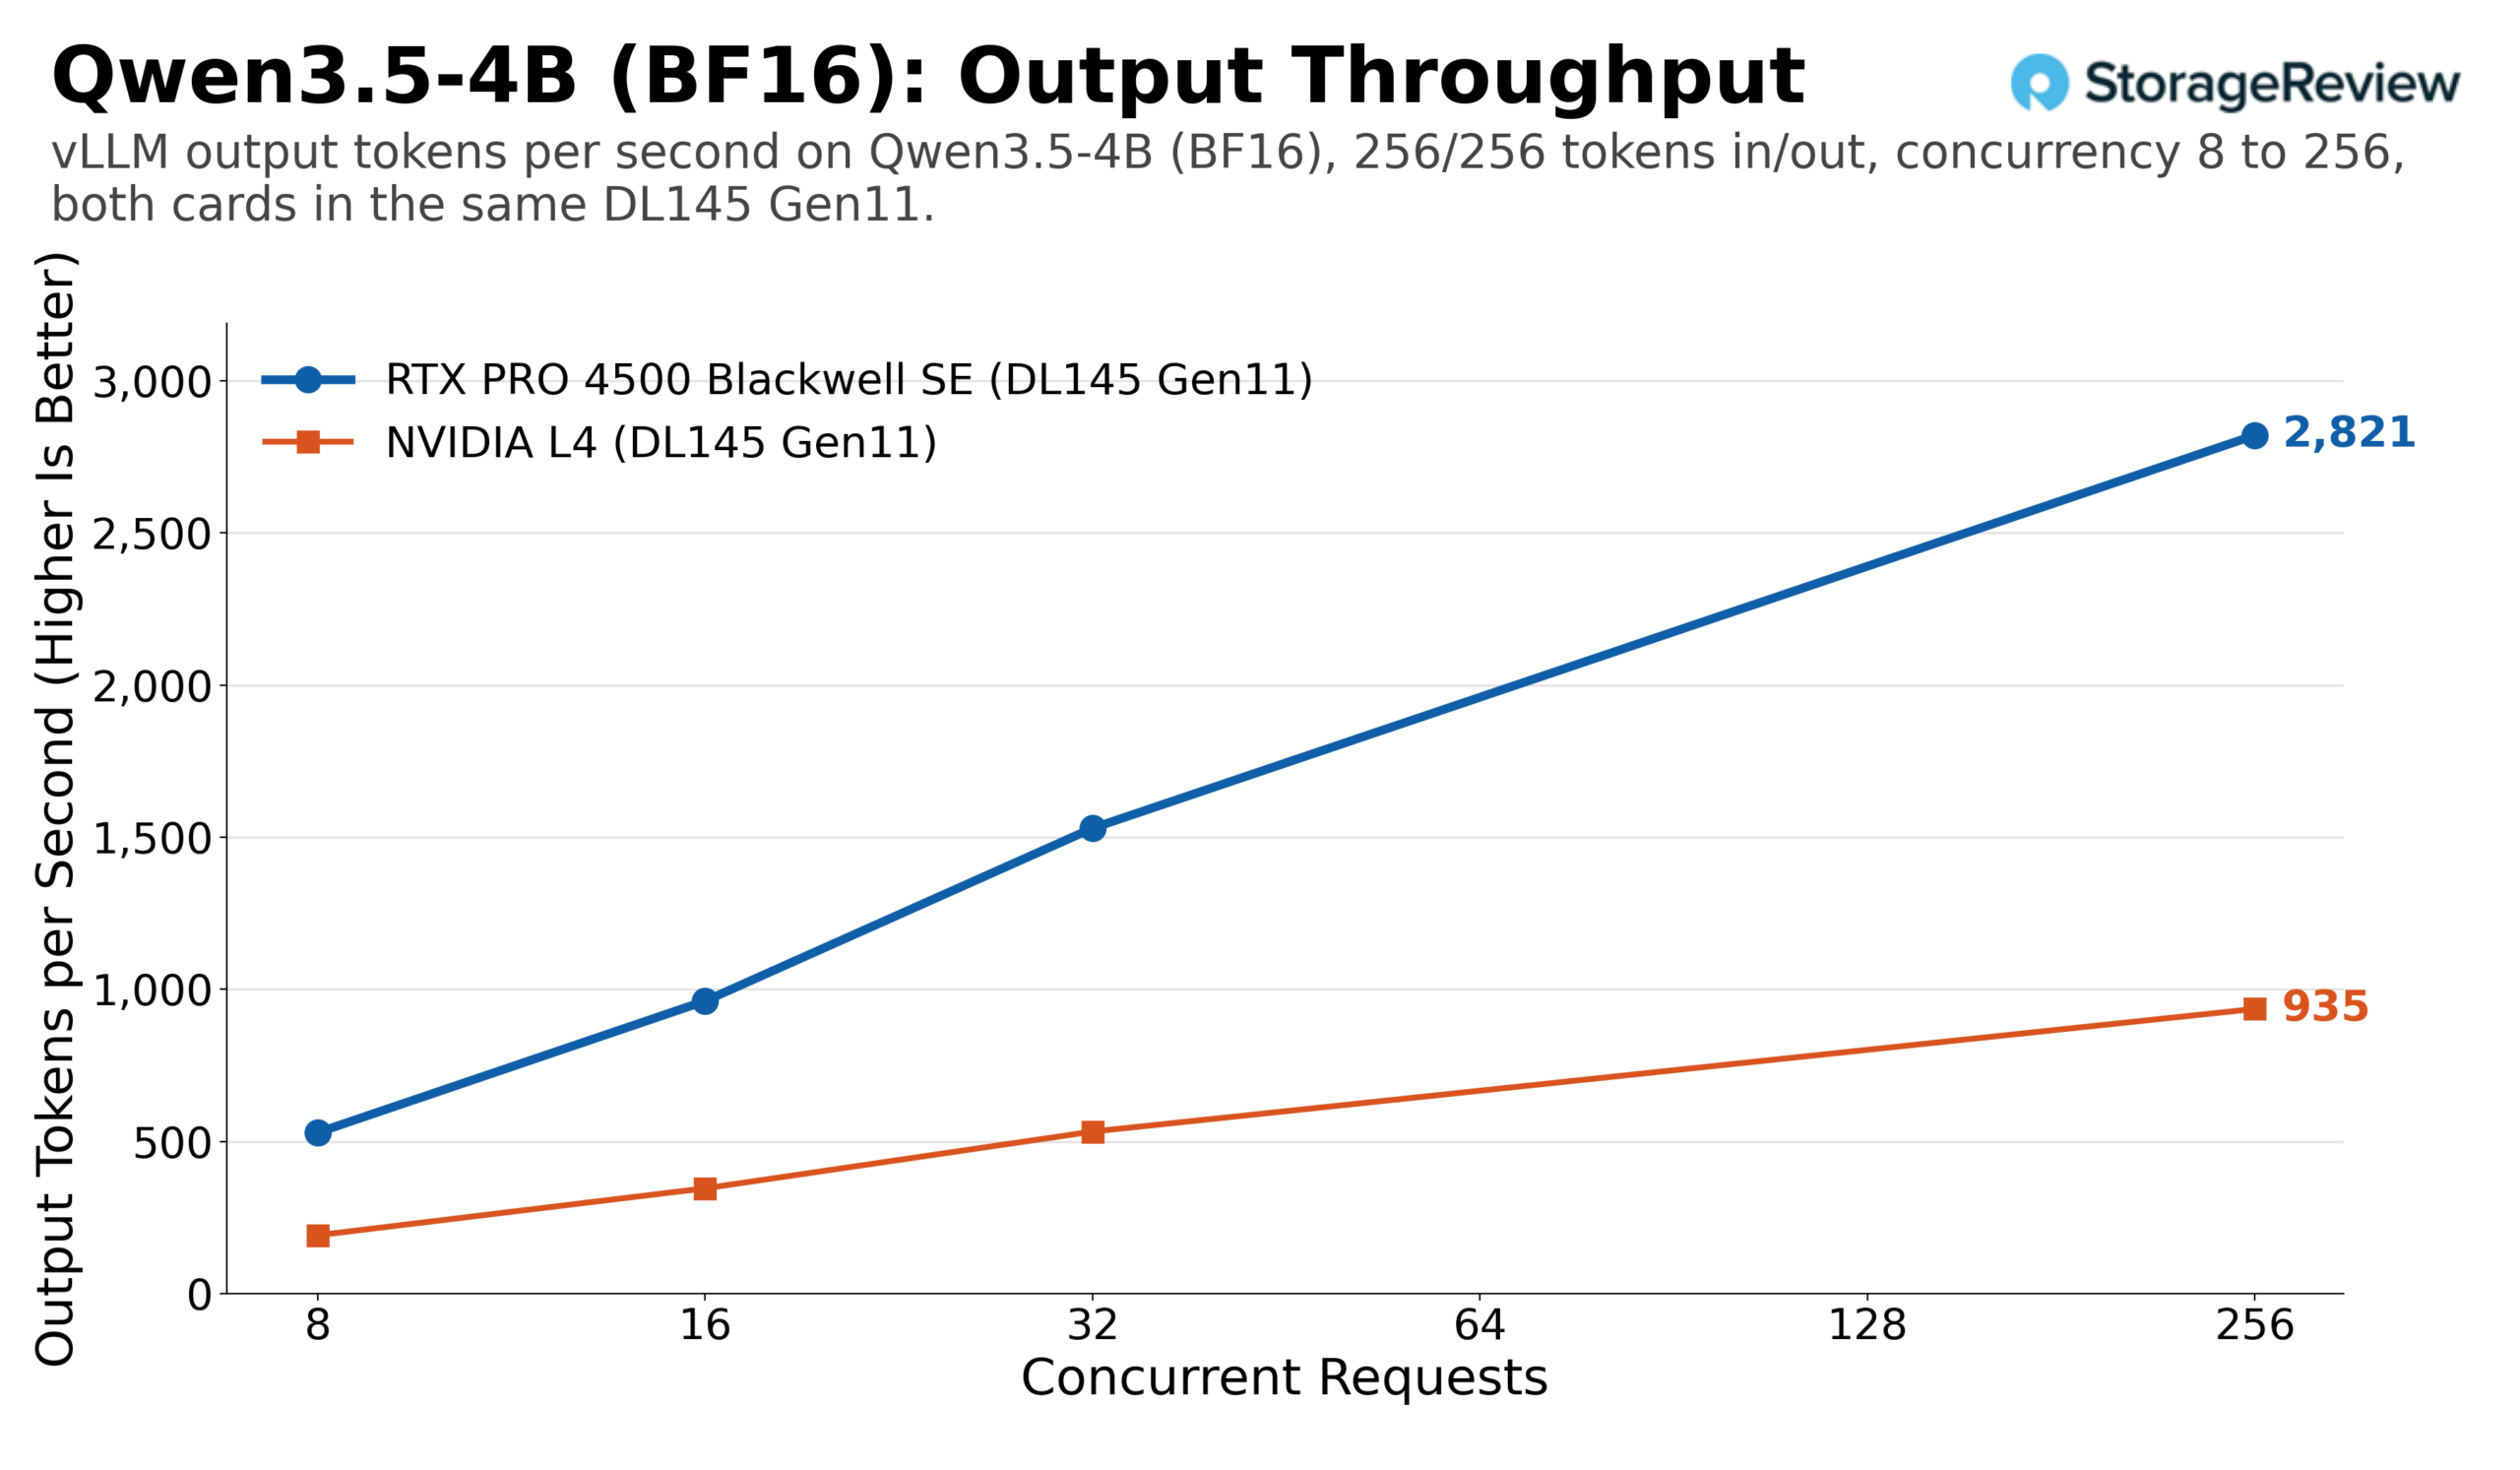
评测团队在HPE ProLiant DL145 Gen11服务器上运行了两款小参数量BF16模型(Qwen3.5-4B和Gemma 4 E4B)的vLLM推理服务。结果显示,在8至32个并发请求的常见负载下,RTX PRO 4500的输出令牌数(output tokens per second)中位数达到L4的2.7倍;而在256并发的高压场景下,这一倍率更升至3.0至3.2倍。延迟方面,RTX PRO 4500单令牌生成耗时12至15毫秒,而L4需要35至40毫秒;当256个并发请求同时涌入,RTX PRO 4500在256令牌长度提示词下的首令牌延迟中位数稳定在264至650毫秒之间,而L4已攀升至9至39秒。StorageReview编辑Brian Beeler强调:“在大多数负载形态下,L4会在32至256个并发会话之间跌宕到每位用户10令牌/秒的体验线以下,而RTX PRO 4500在256并发时仍能保持对除短答案和大提示词外多数场景的流畅覆盖。”
功耗与能效:105W功耗换取2.7倍产出
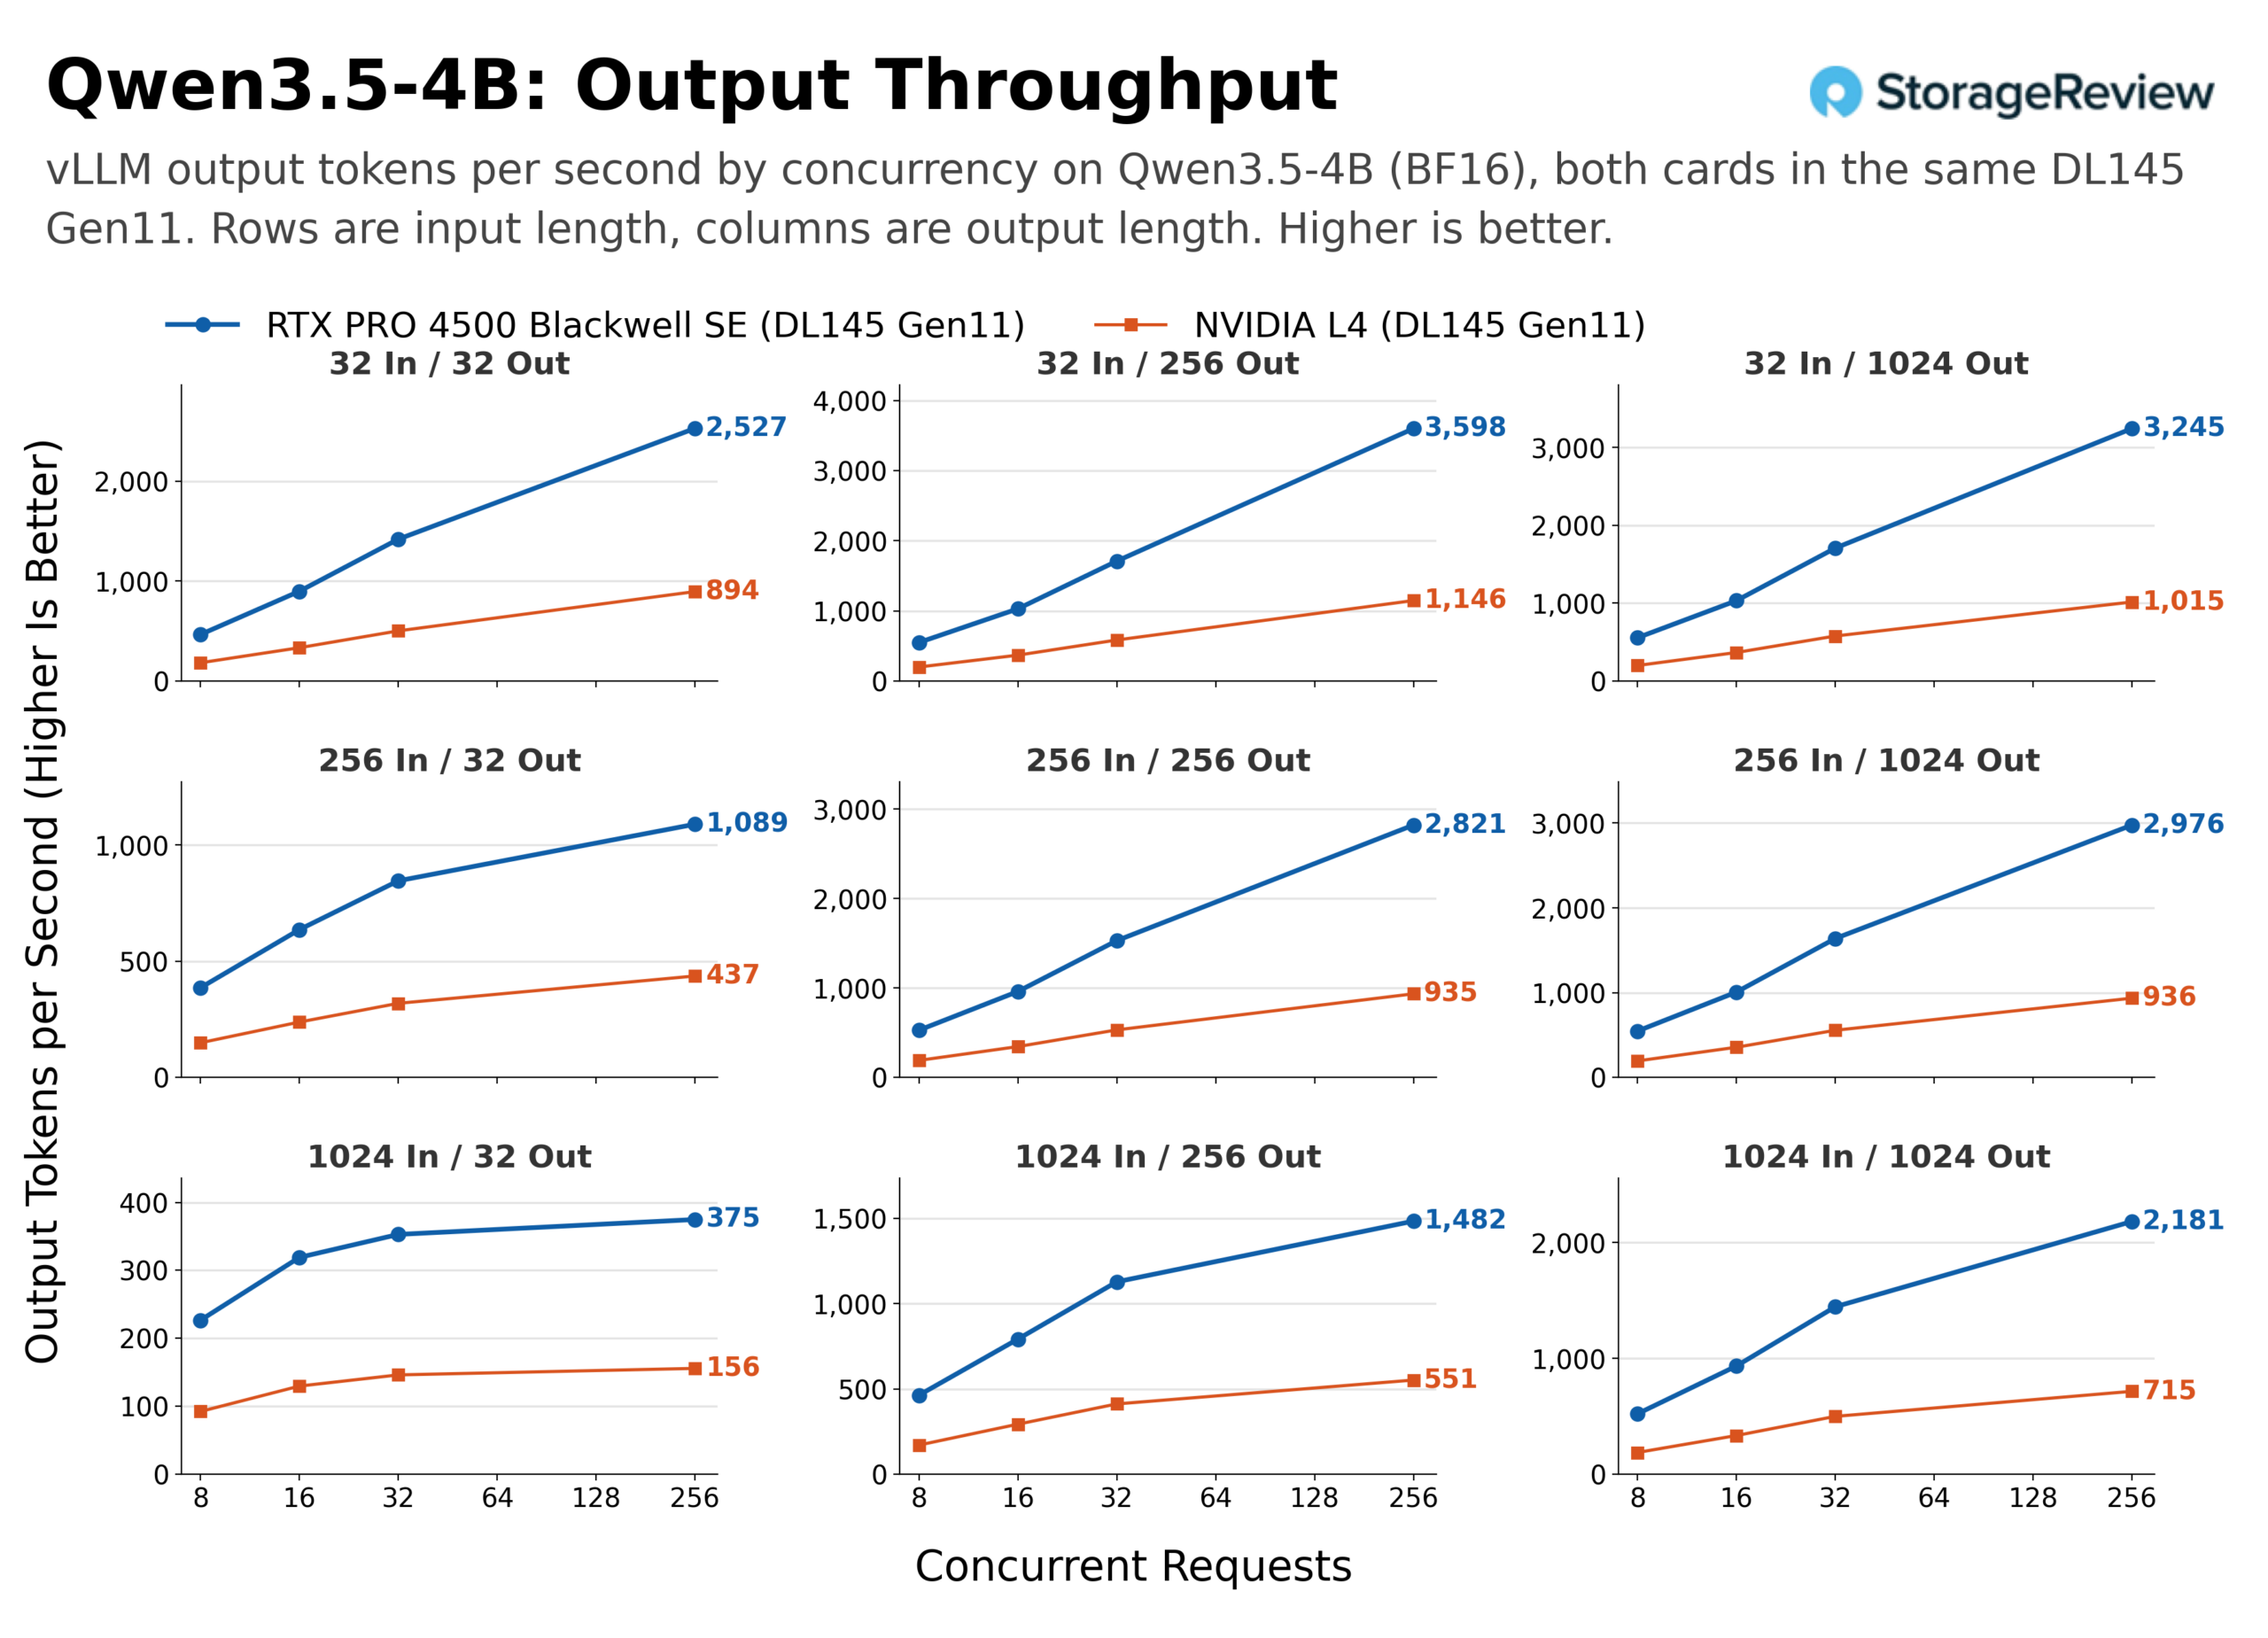
从整服务器功耗看,DL145在搭载L4时服务负载约为196W,换装RTX PRO 4500后升至约301W,增幅105W。但对应输出令牌数的提升,每系统瓦特产出(output tokens per system watt)从L4的2.7(Qwen3.5-4B)/2.9(Gemma 4 E4B)跃升至5.1/5.6,能效提升约1.3至1.4倍。Beeler在评测中写道:“每张卡看,这是能否支撑32至64个同步聊天会话与能否支撑256个会话的差距;就整机而言,DL145最多可装三张L4,三张L4在32并发时的总吞吐量接近一张RTX PRO 4500——因此4500的整机优势更多体现在每位用户的速度、延迟、单一32GB内存池,以及FP4支持上。”
模型兼容性:FP4开辟新模型类别
RTX PRO 4500借助32GB显存和FP4张量核心,能够原生运行L4完全无法承载的大模型。在Gemma 4 26B-A4B的NVFP4量化模型上,使用FP8 KV缓存,RTX PRO 4500在32并发时以165W功耗实现了1,613输出令牌/秒的成绩。作为参照,RTX PRO 6000 Blackwell在工作站中运行同一模型,在8至32并发时功耗为266至471W,对应性能约为前者的两倍;当并发升至256时,差距扩大至约2.5倍。路透社此前报道称,英伟达正在推动FP4精度作为边缘推理的“新标准”,这一实测数据印证了中小规模模型在边缘部署的可行性。
边缘部署实际考量
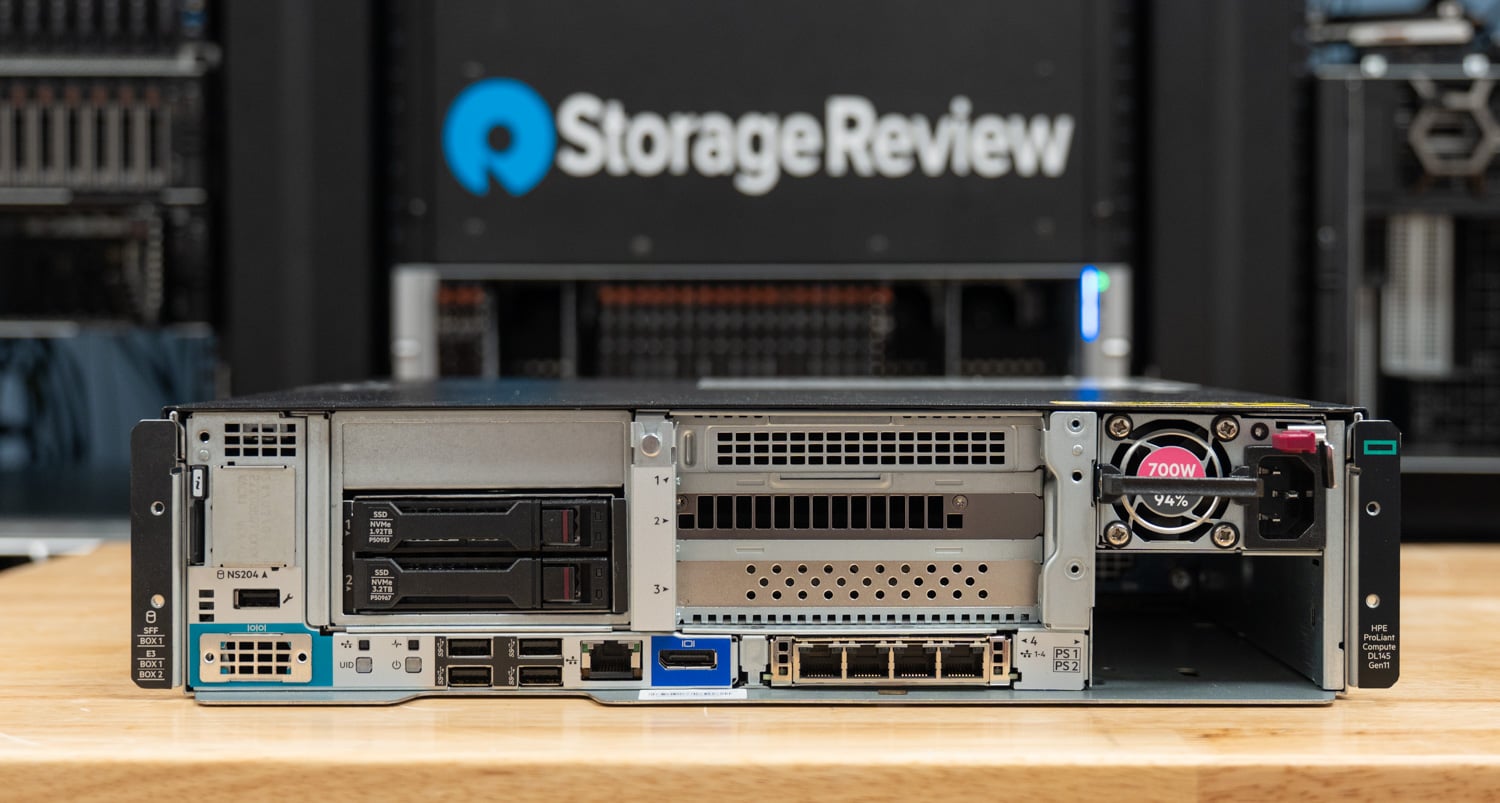
HPE将DL145 Gen11定位为“不需要机房的服务器”。据StorageReview介绍,该服务器可壁挂安装,几乎无声运行,能在-5°C至55°C的环境下工作,适用于零售、医疗、金融、制造和能源等行业的边缘站点。HPE解决方案白皮书指出,其典型工作负载正是本次评测所测量的:小语言模型、检索增强生成(RAG)及向量搜索,在本地运行以绕过延迟敏感或监管敏感数据出站的需求。Beeler指出:“对于已部署L4的站点来说,换装RTX PRO 4500带来的最直接收益就是单节点服务能力翻三倍,以及每位用户更快的响应速度——这在对话式AI和实时推理场景中是体验和成本的双重跃升。”
Q1: RTX PRO 4500比L4快多少?
A1: 在HPE ProLiant DL145 Gen11服务器中,RTX PRO 4500在8至32个并发请求下的输出吞吐量中位数达到L4的2.7倍,在256并发时达到3.0至3.2倍;首令牌延迟在256并发时保持在1秒以内,而L4已飙升到9至39秒。它还能原生运行FP4精度的大模型,例如Gemma 4 26B模型,这是L4不具备的能力。
Q2: 功耗增加了多少?值不值得?
A2: 整机全负载功耗从约196W(L4)升至约301W(RTX PRO 4500),增加约105W。但每瓦特输出的令牌数提升了1.3至1.4倍(从约2.7-2.9提升至5.1-5.6),意味着用电效率实际上升了。考虑到单卡可支持256个并发用户(L4仅能支持32至64个),在总拥有成本和用户体验上通常是值得的升级。
RTX PRO 4500 Blackwell服务器版以2.7倍于L4的推理吞吐、稳定低于1秒的延迟、以及FP4新模型路线,为边缘AI服务器树立了新的性能标杆。对于需要在零售柜台、工厂车间或医院就地运行对话式AI和RAG应用的站点,这款集成了MIG和机密计算的企业级单插槽显卡,提供了一个无需增加物理空间即可将服务容量翻三倍的升级路径。随着边缘AI工作负载从轻量级对话向多模态分析演进,RTX PRO 4500将在2027年成为替代L4的主流选择。